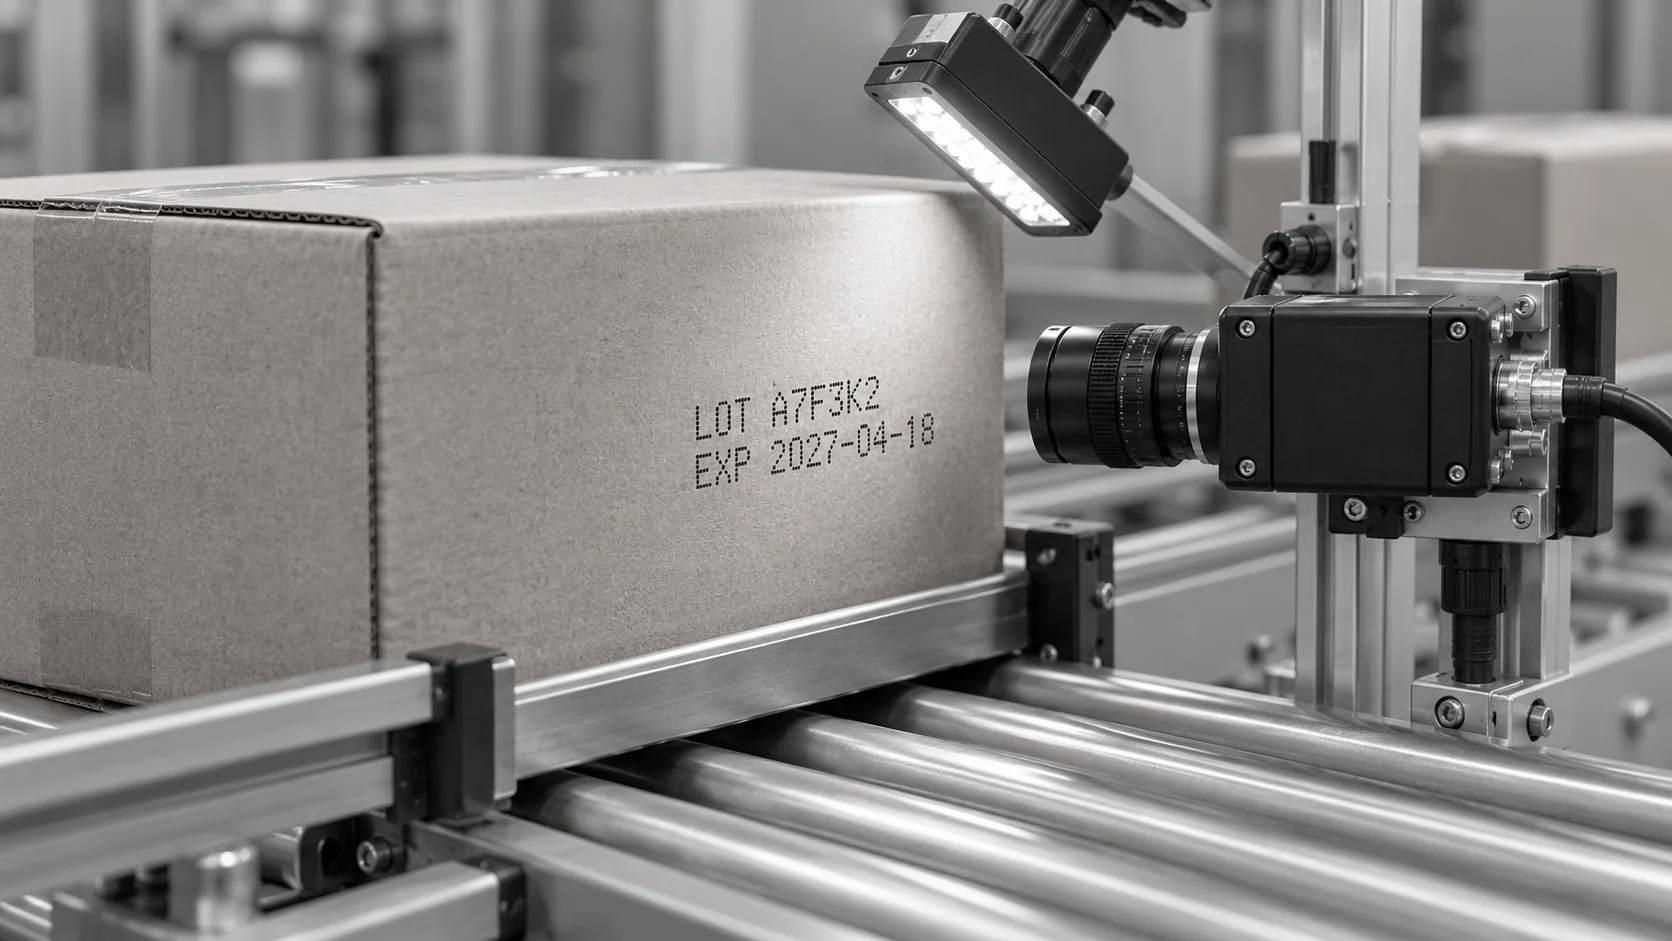
Texterkennung bei schwierigen Vorlagen
- OCR-Inspektion auf Ihre eigenen Schriftarten, Substrate und Druckvariationen trainieren
- Verschmierte, schwache, schiefe und teilweise unterbrochene Zeichen lesen
- Inkjet-, Laser- und Thermotransferdruck auf derselben Plattform verarbeiten
- Lesevorgänge mit geringer Konfidenz zur Überprüfung markieren, statt zu raten
Jedes einzelne Zeichen
Jedes Stück gelesen, nicht nur Stichproben
Ihr Druckbild
Training direkt an Ihrer Linie